看剧学英语,词映 VocScreen-字节Trae创意比赛
词映 VocScreen — 产品介绍文档
看剧学英语,不知不觉的那种 在线体验(建议使用VPN打开):https://vocscreen.vercel.app 注:演示视频由于流量费过高已暂时停止接入,您可以上传自己的本地视频使用~
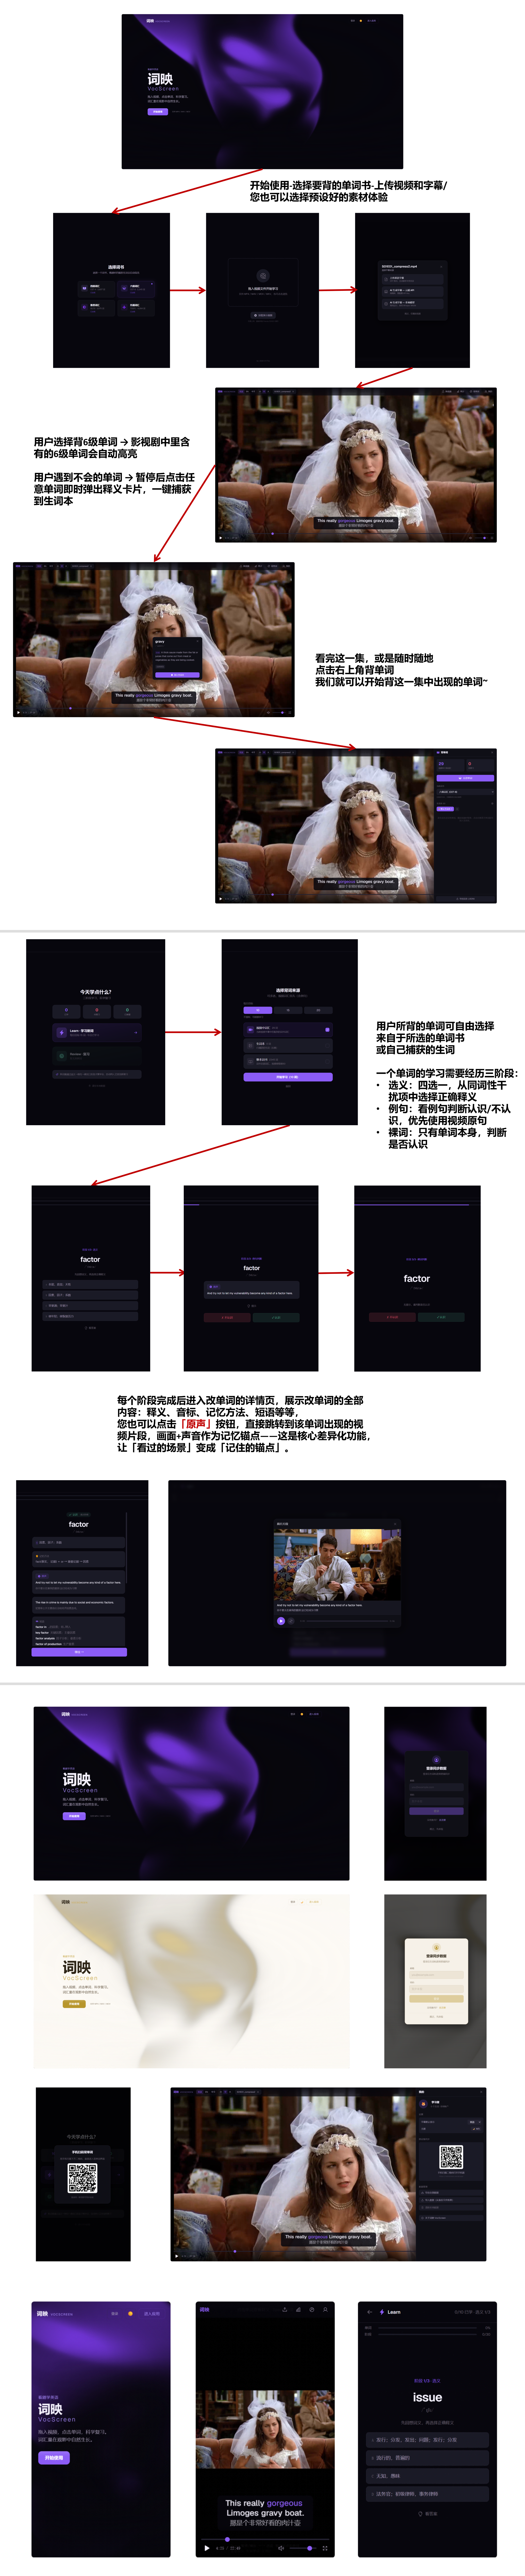
产品使用概览
小tips:这次比赛其实做的东西挺好的,但是展现的形式出现了问题,还是要注重汇报的艺术~
一、产品概述
词映 VocScreen 是一款「看剧学英语」PWA Web 应用。
用户上传任意英文影视剧视频(或使用预设演示视频),系统自动加载双语字幕并基于词书(四级/六级/雅思/托福)高亮匹配单词。观看时点击任意单词即时查看释义、一键捕获到生词本。捕获的生词进入三阶段认知链学习流程(选义 → 例句 → 裸词),学习时可点击「原声」按钮跳转到该单词出现的视频片段,以画面+声音作为记忆锚点。后续按艾宾浩斯遗忘曲线自动安排复习。
核心价值:将「看剧」和「学单词」融为一体,让英语学习变得自然、无痛。
- 版本:v2.0.0
- 技术栈:React 19 + TypeScript + Vite 8 + Tailwind CSS 4 + Zustand + Dexie.js + Supabase + PWA
二、产品定位
2.1 一句话定位
不是「看视频时顺便查词」,而是「看视频时不知不觉学会」。
2.2 核心差异化
市场上没有任何一款产品能同时做到:
- 支持任意视频源(不限于 Netflix/YouTube)
- 基于中国考试词书(四六级/雅思/托福)做单词匹配高亮
- 看剧查词 → 三阶段认知链学习 → 艾宾浩斯复习的完整闭环
- 学习/复习时一键跳转回视频原场景(画面+声音作为记忆锚点)
第 4 点是词映 VocScreen 的核心项目差异化——「视频片段回看」功能让「看过的场景」变成「记住的锚点」。
三、核心功能
3.1 功能总览
| 功能模块 | 说明 |
|---|---|
| 视频播放 + 双语字幕 | 支持上传任意视频,字幕三种来源(用户上传 SRT / 云端 ASR / 本地 Whisper WASM),中英双语自由切换 |
| 单词高亮 + 即时查词 | 基于词书做词形还原匹配,词书单词以淡金色虚线高亮,暂停后点击任意单词弹出释义卡片 |
| 生词捕获 + 生词本 | 一键捕获单词到生词本,自动记录视频片段时间戳,支持多生词本管理 |
| 三阶段认知链学习 | 选义(四选一)→ 例句(判断认识/不认识)→ 裸词(裸词识别),交错学习 |
| 视频片段回看 | 学习/复习时点击「原声」按钮跳转到该单词出现的视频片段 |
| 艾宾浩斯复习 | 1→2→4→7→15→30 天遗忘曲线,连续 6 次「认识」标记为已掌握 |
| 多端同步 | Supabase 云端认证和数据同步,电脑端看剧学单词,手机端随时随地背单词 |
| PWA 离线使用 | 可安装到桌面/手机主屏,离线可用 |
3.2 词书数据
| 词书 | 词条数 | 数据来源 |
|---|---|---|
| 新东方 CET4 | 2607 | 新东方 JSONL |
| 新东方 CET6 | 2345 | 新东方 JSONL |
| 新东方 IELTS | 3575 | 新东方 JSONL |
| 新东方 TOEFL | 4264 | 新东方 JSONL |
每个词条包含以下字段:
| 字段 | 说明 | 示例 |
|---|---|---|
spelling | 拼写 | anybody |
lemma | 词形还原 | anybody |
phonetics | 音标 | /ˈenibɒdi/ |
definition | 释义(纯中文) | 任何人 |
exampleSentence | 词书例句 | Is anybody there? |
exampleTranslation | 例句翻译 | 有人在吗? |
mnemonic | 记忆方法 | any(任何)+ body(人) |
phrases | 短语 | [{content: “anybody else”, translation: “其他人”}] |
synonyms | 同近义词 | [{pos: “pron.”, translation: “任何人”, words: [“anyone”]}] |
relatedWords | 同根词 | [{pos: “n.”, words: [{word: “nobody”, translation: “没有人”}]}] |
examSentences | 真题例句 | [{en: “Does anybody know?”, source: “CET4 2020”}] |
四、产品架构
4.1 整体架构
┌─────────────────────────────────────────────────────────────────┐
│                         客户端 (PWA)                              │
│                                                                  │
│  ┌──────────────┐  ┌──────────────┐  ┌──────────────────────┐   │
│  │   组件层      │  │   状态层      │  │      引擎层           │   │
│  │  Components   │  │   Stores     │  │     Engines          │   │
│  │              │  │              │  │                      │   │
│  │ • Player     │◄─┤ • Player     │◄─┤ • SubtitleRenderer   │   │
│  │ • Memorize   │  │ • Subtitle   │  │ • SrtParser          │   │
│  │ • Vocab      │  │ • Vocab      │  │ • MatcherEngine      │   │
│  │ • Toolbar    │  │ • UI         │  │ • Lemmatizer         │   │
│  │ • Auth       │  │ • Review     │  │ • AsrEngine          │   │
│  │ • Landing    │  │ • Auth       │  │ • TranslateEngine    │   │
│  │ • UI Prims   │  │              │  │ • DictEngine         │   │
│  └──────┬───────┘  └──────┬───────┘  │ • ClipCapture        │   │
│         │                 │          └──────────┬───────────┘   │
│         └────────┬────────┴─────────────────────┘               │
│                  ▼                                               │
│         ┌────────────────┐                                      │
│         │   数据层        │                                      │
│         │  IndexedDB     │                                      │
│         │  (Dexie.js)    │                                      │
│         │  9 张表         │                                      │
│         └───────┬────────┘                                      │
└─────────────────┼───────────────────────────────────────────────┘
                  │
                  ▼
         ┌────────────────┐
         │   云端服务      │
         │                │
         │ • Supabase     │ ← 认证 + PostgreSQL + RLS
         │   Auth         │
         │   Database     │
         │                │
         │ • 腾讯 COS      │ ← 视频存储 (Range 请求)
         │                │
         │ • Vercel        │ ← 前端托管 + CDN
         └────────────────┘
4.2 核心数据流
用户上传视频
    │
    ├──► 字幕来源三选一 ──┬── 用户上传 SRT 文件 ──► SrtParser 解析
    │                     ├── 云端 ASR API ──► AsrEngine 识别
    │                     └── 本地 Whisper WASM ──► 离线识别
    │
    ▼
字幕段 (SubtitleSegment[])
    │
    ├──► MatcherEngine ──► 词形还原匹配 (Lemmatizer)
    │         │
    │         ▼
    │    高亮单词列表 (HighlightedWord[])
    │         │
    │         ▼
    │    SubtitleRenderer ──► Canvas 渲染双语字幕 + 高亮
    │
    ▼
用户点击单词
    │
    ├──► DictEngine ──► 释义卡片 (DefinitionCard)
    │
    ├──► 一键捕获 ──► IndexedDB (capturedWords) ──► Supabase 同步
    │
    ▼
三阶段认知链学习
    │
    ├── 阶段1: ChoiceStage (选义 · 四选一)
    ├── 阶段2: ContextStage (例句 · 判断认识/不认识)
    ├── 阶段3: BareStage (裸词 · 裸词识别)
    │
    ├── 每阶段后 ──► WordDetailView (详情页 · 全部词书内容)
    │                └── 「原声」按钮 ──► VideoClipModal (视频片段回看)
    │
    ▼
艾宾浩斯复习队列
    │
    ├── 1天 → 2天 → 4天 → 7天 → 15天 → 30天
    ├── 连续 6 次「认识」─► 标记为已掌握
    └── 复习时仍可点击「原声」回看视频片段
4.3 状态管理架构
应用使用 Zustand 管理 6 个独立 store,各 store 职责清晰、互不耦合:
| Store | 职责 | 核心状态 |
|---|---|---|
usePlayerStore | 视频播放器 | videoBlobUrl, isPlaying, currentTime, duration, volume, isDemoMode |
useSubtitleStore | 字幕数据 | segments, matchSummary, subtitleSource, subtitleDisplay |
useVocabStore | 词汇数据 | combinedDict, loadedBooks, capturedWords, notebooks |
useReviewStore | 复习计划 | schedules, reviewQueue, dueCount |
useUIStore | UI 状态 | appScreen, theme, selectedWordBookId, authModalOpen |
useAuthStore | 认证状态 | user, username, pendingEmail |
五、技术路线
5.1 技术栈
| 层级 | 技术 | 版本 | 说明 |
|---|---|---|---|
| 前端框架 | React | 19.2 | 函数组件 + Hooks |
| 类型系统 | TypeScript | 6.0 | 严格模式,全量类型覆盖 |
| 构建工具 | Vite | 8.1 | 极速 HMR,ESBuild 预构建 |
| 样式方案 | Tailwind CSS | 4.3 | 原子化 CSS,暗色主题 |
| 状态管理 | Zustand | 5.0 | 轻量,6 个独立 store |
| 动画库 | Motion | 12.4 | 页面过渡和微交互(Framer Motion) |
| 图标库 | Phosphor Icons | 2.1 | 统一图标风格 |
| 本地存储 | Dexie.js | 4.4 | IndexedDB 封装,9 张表 |
| 云端认证 | Supabase Auth | 2.110 | 邮箱验证登录 |
| 云数据库 | Supabase PostgreSQL | — | RLS 行级安全,数据隔离 |
| 视频存储 | 腾讯 COS | — | Range 请求,分段加载 |
| PWA | vite-plugin-pwa | 1.3 | Workbox,可安装,离线可用 |
| NLP | Compromise | 14.15 | 英文分词和词性标注 |
| WebGL | OGL | 1.0 | 启动页 Plasma 粒子背景 |
5.2 构建优化
- 代码分割:
manualChunks拆分大型依赖(motion、phosphor-icons、dexie、compromise)为独立 chunk,减少主包体积 - PWA 缓存策略:词书 JSON(5-6MB)不预缓存,改为运行时
StaleWhileRevalidate按需缓存 - 字幕数据内联:演示视频字幕直接 import JSON 到 JS bundle,不走网络请求,100% 可靠加载
- Tree Shaking:Vite 生产构建自动移除未使用代码
5.3 关键技术决策
| 决策 | 选择 | 理由 |
|---|---|---|
| 字幕渲染方式 | Canvas | 不阻塞 DOM,可精确控制单词级高亮坐标 |
| 状态管理 | Zustand(非 Redux) | 轻量,无 boilerplate,适合中等复杂度应用 |
| 本地存储 | Dexie.js(非 localStorage) | 支持复杂查询、索引、大量数据,9 张表结构化存储 |
| 认证方式 | Supabase Auth(非自建) | 免去后端开发,邮箱验证开箱即用,RLS 数据隔离 |
| 视频存储 | 腾讯 COS(非打包进项目) | 300MB+ 视频文件不适合打包,COS 支持 Range 请求分段加载 |
| 部署平台 | Vercel(非自建服务器) | 零配置部署,自动 HTTPS,CDN 加速,Git push 自动部署 |
六、项目结构
vocscreen_v2/
├── public/
│   ├── mock/
│   │   └── friends-s01e01/          # 演示视频字幕(public 副本,已弃用)
│   ├── wordbooks/                   # 词书 JSON 文件
│   │   ├── cet4.json                # 新东方四级 (2607 词)
│   │   ├── cet6.json                # 新东方六级 (2345 词)
│   │   ├── ielts.json               # 新东方雅思 (3575 词)
│   │   └── toefl.json               # 新东方托福 (4264 词)
│   ├── icon-192.png                 # PWA 图标
│   ├── icon-512.png                 # PWA 图标
│   └── icon.svg                     # SVG 图标
│
├── src/
│   ├── components/                  # UI 组件层
│   │   ├── auth/
│   │   │   └── AuthModal.tsx        # 登录/注册弹窗(邮箱验证)
│   │   ├── landing/
│   │   │   ├── StartPage.tsx        # 启动页(WebGL Plasma 背景)
│   │   │   ├── WordBookSelect.tsx   # 词书选择页
│   │   │   └── Plasma.tsx           # WebGL 粒子背景引擎
│   │   ├── player/
│   │   │   ├── VideoPlayer.tsx      # 视频播放器(<video> + Canvas 字幕)
│   │   │   ├── VideoDropZone.tsx    # 视频拖放/上传区域 + 加载演示按钮
│   │   │   ├── SubtitleCanvas.tsx   # Canvas 字幕渲染(单词级高亮)
│   │   │   ├── VideoControls.tsx    # 播放控制条
│   │   │   ├── WordTooltip.tsx      # 单词释义弹窗
│   │   │   └── SubtitleSourceModal.tsx # 字幕来源选择弹窗
│   │   ├── memorize/
│   │   │   ├── MemorizeScreen.tsx   # 学习屏幕(队列管理、阶段流转)
│   │   │   ├── VideoClipModal.tsx   # 视频片段回看弹窗
│   │   │   └── stages/
│   │   │       ├── ChoiceStage.tsx      # 阶段1:选义(四选一)
│   │   │       ├── ContextStage.tsx     # 阶段2:例句判断
│   │   │       ├── BareStage.tsx        # 阶段3:裸词识别
│   │   │       ├── WordDetailView.tsx   # 单词详情页(全部词书内容)
│   │   │       ├── LearnCompleteView.tsx # 学习完成视图
│   │   │       └── ReviewFailView.tsx   # 复习失败视图
│   │   ├── vocab/
│   │   │   ├── DashboardPanel.tsx   # 背单词面板(学习+复习入口)
│   │   │   ├── DefinitionCard.tsx   # 释义卡片
│   │   │   └── ProfilePanel.tsx     # 个人中心(统计、清空数据)
│   │   ├── toolbar/
│   │   │   └── TopToolbar.tsx       # 顶部工具栏
│   │   ├── stats/
│   │   │   └── StatsPanel.tsx       # 统计面板
│   │   ├── ui/
│   │   │   ├── Modal.tsx            # 模态框
│   │   │   ├── Drawer.tsx           # 抽屉
│   │   │   ├── Toast.tsx            # 轻提示
│   │   │   └── ProgressBar.tsx      # 进度条
│   │   └── ErrorBoundary.tsx        # 错误边界
│   │
│   ├── engines/                     # 引擎层(纯逻辑,无 UI 依赖)
│   │   ├── subtitle/
│   │   │   ├── SrtParser.ts         # SRT 字幕解析器
│   │   │   ├── SubtitleRenderer.ts  # Canvas 字幕渲染器
│   │   │   ├── TranslateEngine.ts   # 翻译引擎(本地 NLLB + 云端 API)
│   │   │   └── MockLoader.ts        # 演示字幕加载器
│   │   ├── matching/
│   │   │   ├── MatcherEngine.ts     # 单词匹配引擎(词书联动)
│   │   │   └── Lemmatizer.ts        # 词形还原引擎
│   │   ├── asr/
│   │   │   ├── AsrEngine.ts         # ASR 引擎接口
│   │   │   ├── WhisperLocal.ts      # 本地 Whisper WASM 引擎
│   │   │   ├── CloudAsr.ts          # 云端 ASR API 引擎
│   │   │   └── AudioExtractor.ts    # 音频提取器
│   │   ├── dict/
│   │   │   └── DictEngine.ts        # 词典 API 引擎
│   │   └── capture/
│   │       └── ClipCapture.ts       # 视频片段捕获器
│   │
│   ├── stores/                      # Zustand 状态管理
│   │   ├── usePlayerStore.ts        # 播放器状态
│   │   ├── useSubtitleStore.ts      # 字幕状态
│   │   ├── useVocabStore.ts         # 词汇状态
│   │   ├── useReviewStore.ts        # 复习计划状态
│   │   ├── useUIStore.ts            # UI 状态
│   │   └── useAuthStore.ts          # 认证状态
│   │
│   ├── db/
│   │   └── database.ts              # Dexie.js 数据库(9 张表)
│   │
│   ├── lib/
│   │   ├── supabase.ts              # Supabase 客户端
│   │   ├── sync.ts                  # 云同步逻辑
│   │   ├── distractors.ts           # 干扰项生成
│   │   └── asrSettings.ts           # ASR 设置
│   │
│   ├── hooks/
│   │   ├── useKeyboardShortcuts.ts  # 键盘快捷键
│   │   ├── useDemoTimeline.ts       # Demo 模式时间线
│   │   └── useVideoEndDetection.ts  # 视频结束检测
│   │
│   ├── types/
│   │   ├── index.ts                 # 类型导出入口
│   │   ├── vocabulary.ts            # 词汇类型
│   │   ├── subtitle.ts              # 字幕类型
│   │   ├── review.ts                # 复习类型
│   │   ├── video.ts                 # 视频类型
│   │   └── engine.ts                # 引擎类型
│   │
│   ├── mock/
│   │   └── friends-s01e01/
│   │       ├── subtitles.json       # 演示字幕(349 条,直接 import)
│   │       └── metadata.json        # 演示元数据
│   │
│   ├── App.tsx                      # 应用根组件(路由 + 认证)
│   ├── main.tsx                     # 应用入口
│   └── index.css                    # 全局样式
│
├── .trae/documents/                 # 项目文档
│   ├── product-specification.md     # 产品项目文档
│   ├── competition-submission.md    # 比赛提交文档
│   ├── supabase-schema.sql          # Supabase 数据库 Schema
│   └── ...
│
├── scripts/
│   └── convert_xdf_wordbooks.py     # 新东方词书转换脚本
│
├── vite.config.ts                   # Vite 构建配置
├── tsconfig.json                    # TypeScript 配置
├── tailwind.config.ts               # Tailwind 配置
├── vercel.json                      # Vercel 部署配置
└── package.json                     # 项目依赖
七、数据架构
7.1 本地数据库(IndexedDB / Dexie.js)
应用使用 Dexie.js 封装 IndexedDB,共 9 张表,版本迭代至 v3:
| 表名 | 用途 | 索引字段 |
|---|---|---|
videos | 视频记录 | id, createdAt |
subtitleSegments | 字幕段 | id, videoId, startTime |
wordEntries | 词条 | id, spelling, lemma, level |
capturedWords | 捕获的生词 | id, wordEntryId, spelling, status, notebookId |
reviewSchedules | 复习计划 | id, capturedWordId, nextReviewAt, status |
userStats | 用户统计 | id |
clips | 视频片段 | id, capturedWordId |
notebooks | 生词本 | id, createdAt |
dailyLearnRecords | 每日学习记录 | id, date, wordId, completedAt |
7.2 云端数据库(Supabase PostgreSQL)
| 表名 | 用途 | RLS 策略 |
|---|---|---|
profiles | 用户资料(username) | 用户只能读写自己的 profile |
notebooks | 生词本 | 用户只能 CRUD 自己的生词本 |
captured_words | 捕获的生词 | 用户只能 CRUD 自己的生词 |
review_schedules | 复习计划 | 用户只能 CRUD 自己的复习计划 |
所有表均启用 Row Level Security (RLS),通过 auth.uid() = user_id 策略确保用户只能访问自己的数据。
7.3 核心数据模型
// 词条(来自词书)
interface WordEntry {
  id: string
  spelling: string           // 拼写
  lemma: string              // 词形还原
  phonetics: string          // 音标
  definition: string         // 释义(纯中文)
  level: string              // 等级(CET4/CET6/IELTS/TOEFL)
  frequency: number          // 频率
  tags: string[]
  exampleSentence?: string   // 词书例句
  exampleTranslation?: string
  phrases?: Phrase[]         // 短语
  relatedWords?: RelatedWordGroup[]  // 同根词
  synonyms?: SynonymGroup[]  // 同近义词
  mnemonic?: string          // 记忆方法
  examSentences?: ExamSentence[]     // 真题例句
}

// 捕获的生词
interface CapturedWord {
  id: string
  wordEntryId: string
  spelling: string
  lemma: string
  source: SourceContext      // 来源上下文(视频片段信息)
  status: WordStatus         // new | learning | fuzzy | mastered
  capturedAt: number
  learnedAt?: number
  notebookId?: string
}

// 视频来源上下文
interface SourceContext {
  videoId: string
  subtitleSegmentId: string
  timestamp: number
  sentenceEn: string         // 视频原句(英文)
  sentenceZh: string         // 视频原句(中文)
  videoClipStart: number     // 视频片段开始时间
  videoClipEnd?: number      // 视频片段结束时间
}

// 艾宾浩斯复习计划
interface EbbinghausSchedule {
  id: string
  capturedWordId: string
  intervals: number[]        // [1, 2, 4, 7, 15, 30]
  currentIntervalIndex: number
  lastReviewAt: number | null
  nextReviewAt: number
  reviewCount: number
  consecutivePass: number    // 连续通过次数(6次=掌握)
  ease: number               // 难度系数
  status: 'active' | 'mastered' | 'paused'
  learnStage: LearnStage
}

// 字幕段
interface SubtitleSegment {
  id: string
  videoId: string
  startTime: number
  endTime: number
  textEn: string             // 英文原句
  textZh: string             // 中文翻译
  alignment: WordAlignment[] // 单词级位置数据
  highlightedWords: HighlightedWord[]  // 匹配词书的单词
}
八、功能详解
8.1 视频播放 + 双语字幕
字幕来源(三选一):
- 用户上传 SRT 字幕:支持标准 SRT 格式,SrtParser 解析为 SubtitleSegment[]
- 云端 ASR API:提取视频音频,发送到云端 ASR 服务识别为英文字幕
- 本地 Whisper WASM:浏览器内运行 Whisper 模型,离线识别英文字幕(隐私保护,无需联网)
字幕渲染:
- 使用 Canvas 渲染字幕(不阻塞 DOM,可精确控制单词级高亮坐标)
- 中英双语,支持三种显示模式:双语 / 仅英文 / 仅中文
- 英文字幕使用 middle baseline 对齐,中英之间 2px 间距
- 匹配词书的单词以淡金色虚线高亮
视频播放:
- 支持 MP4 / WebM / MKV 等常见格式
- 支持本地文件拖放上传
- 支持云端 URL 加载(腾讯 COS + Range 请求)
- 播放控制:播放/暂停(Space)、进度拖动、音量调节
8.2 单词高亮 + 即时查词
词形还原匹配:
- Lemmatizer 引擎对字幕中每个单词做词形还原(如
didn't→don't,running→run) - 保留缩写撇号(
didn't而非didnt) - MatcherEngine 将还原后的词与词书词条做匹配
- 匹配成功的单词在 Canvas 上以淡金色虚线高亮
即时查词:
- 暂停视频后,点击任意单词弹出释义卡片(WordTooltip)
- 释义卡片显示:拼写、音标、释义、词性
- 点击「捕获」按钮将单词加入生词本,自动记录视频片段时间戳
8.3 三阶段认知链学习
设计理念: 交错学习(Interleaved Learning),不同单词交替通过各阶段,避免单单词连续学习导致的短时记忆虚假掌握。
阶段1:选义 (ChoiceStage)
├── 展示单词 + 音标
├── 四选一:从同词性干扰项中选择正确释义
├── 干扰项从所有词书中选取同词性单词
└── 答对 → 进入阶段2;答错 → 重新开始

         ↓

阶段2:例句 (ContextStage)
├── 展示单词 + 例句(优先视频原句,其次词书例句,最后词典 API)
├── 判断「认识」或「不认识」
├── 判断阶段隐藏中文翻译
└── 点击「原声」可跳转视频片段(仅显示英文)

         ↓

阶段3:裸词 (BareStage)
├── 仅展示单词本身(无音标、无释义、无例句)
├── 判断「认识」或「不认识」
└── 测试纯粹的记忆提取能力

         ↓

详情页 (WordDetailView)
├── 释义 + 音标
├── 视频原句 + 「原声」按钮
├── 词书例句
├── 记忆方法
├── 短语
├── 同近义词
├── 同根词
└── 真题例句(可折叠)

         ↓

学习完成 → 加入艾宾浩斯复习队列
8.4 视频片段回看
核心差异化功能。
- 学习/复习时点击「原声」按钮,弹出 VideoClipModal
- 弹窗内播放该单词出现的视频片段(自动定位到
videoClipStart~videoClipEnd) - 视频下方显示对应的视频原句(
videoSentence,非词书例句) - 画面+声音作为记忆锚点——「看过的场景」变成「记住的锚点」
关键约束:
videoSentence(视频字幕原句)和exampleSentence(词书例句)是独立字段,不可合并- 「原声」按钮始终对应
videoSentence,确保文本与音频一致 videoClipStart/videoClipEnd时间戳独立保存,即使使用词书例句也不丢失
8.5 艾宾浩斯复习
复习间隔:1天 → 2天 → 4天 → 7天 → 15天 → 30天

每次复习:
├── 「认识」→ 间隔升级(如 1天 → 2天),连续通过 +1
├── 「不认识」→ 间隔重置为 1天,连续通过归零
└── 连续 6 次「认识」→ 标记为「已掌握」(mastered)

每日复习:
├── 自动检查 nextReviewAt <= 当前时间的单词
├── 生成复习队列
└── 复习时仍可点击「原声」回看视频片段
8.6 多端同步
- Supabase Auth:邮箱验证登录,
onAuthStateChange监听认证状态 - 首次登录迁移:游客数据(IndexedDB)登录后自动上传到云端
- 增量同步:每次操作(捕获/学习/复习)后自动同步单条记录到 Supabase
- 拉取同步:登录后从 Supabase 拉取数据到本地 IndexedDB
- RLS 隔离:Supabase Row Level Security 确保用户只能访问自己的数据
九、产品形态
9.1 当前形态
- PWA Web 应用:浏览器打开 HTTPS 链接即用,无需下载安装
- 响应式设计:同时适配电脑端(横屏看视频)和手机端(竖屏背单词)
- 可安装:支持安装到桌面/手机主屏,像原生 App 一样使用
- 离线可用:PWA Service Worker 缓存核心资源,离线可背单词
9.2 未来形态
- 桌面应用:通过 PWA 安装到桌面,或打包为 Electron 应用
- 移动应用:通过 PWA 安装到手机主屏,或封装为原生 App
- 影视 APP 深度联动:与视频平台合作,看剧时自动推荐生词
- 浏览器扩展:在任意视频网站上使用词映功能
十、核心用户
10.1 用户画像
| 用户类型 | 占比 | 场景 | 核心需求 |
|---|---|---|---|
| 英语考试备考者 | 60% | 备考四六级/考研/雅思/托福 | 高效背单词,通过考试 |
| 职场英语提升者 | 20% | 看美剧/英文视频提升职场英语 | 实用词汇,场景记忆 |
| 英语爱好者 | 15% | 看原版电影/纪录片 | 无障碍观看英文内容 |
| 留学生/海外工作者 | 5% | 日常英语交流 | 扩大词汇量,地道表达 |
10.2 使用场景
电脑端(看剧学单词):
- 打开网站,选择词书(如六级)
- 上传视频或加载演示视频
- 看视频,字幕中匹配词书的单词高亮
- 暂停,点击生词查看释义,一键捕获
- 视频结束后进入学习流程
手机端(随时随地背单词):
- 手机浏览器打开同一链接
- 登录同一账号,自动同步生词和复习计划
- 点击「背单词」进入学习/复习
- 学习时点击「原声」回看视频片段
- 可安装到主屏,像 App 一样使用
十一、灵感来源
11.1 「不背单词」App
- 借鉴:三阶段认知链的学习交互范式(选义 → 例句 → 裸词)
- 改进:加入「视频片段回看」,用真实场景代替孤立例句
11.2 Language Reactor
- 借鉴:双语字幕 + 单词查词的看剧体验
- 改进:不限于 Netflix/YouTube,支持任意视频源;有词书体系和科学复习
11.3 个人痛点
作为英语学习者,背单词总停留在 abandon 附近就放弃。希望有一种「不用刻意学,但确实能学到」的方式。如果把视频场景作为记忆锚点,让系统自动服务而非要求用户主动操作,看剧本身就能变成可持续的词汇积累过程。
十二、想解决的问题
12.1 学习场景割裂
看剧时查了单词,之后再也想不起来复习。查词归查词,复习归复习,没有把「视频场景」作为记忆锚点。
12.2 背单词枯燥
传统背单词 App 脱离语境,「abandon 放弃」式的孤岛记忆,记了就忘。
12.3 视频字幕工具缺失
- Chrome 插件只能寄生在 Netflix/YouTube 上
- 没有词书体系——四六级/雅思/托福这些中国用户最在乎的,一个都没有
- 没有本地 ASR,用户必须有现成字幕才能用
- 看剧时暂停查词太麻烦,导致「知道能学,但学不起来」
十三、现有产品对比
| 维度 | 不背单词 | 墨墨背单词 | Language Reactor | 词映 VocScreen |
|---|---|---|---|---|
| 看剧学单词 | ❌ | ❌ | ✅(仅 Netflix/YT) | ✅(任意视频) |
| 科学复习 | ✅ | ✅ | ❌ | ✅(艾宾浩斯) |
| 多词书支持 | ✅ | ✅ | ❌ | ✅(新东方四六级/雅思/托福) |
| 视频片段回看 | ❌ | ❌ | ❌ | ✅(核心差异化) |
| 离线可用 | 部分 | ✅ | ❌ | ✅ (PWA) |
| 跨设备同步 | ✅ | ✅ | ❌ | ✅ (Supabase) |
| 开放视频源 | ❌ | ❌ | 仅浏览器插件 | ✅ 支持任意视频 |
| 本地 ASR | ❌ | ❌ | ❌ | ✅ (Whisper WASM) |
| 单词详情 | 释义+例句 | 释义+例句 | 仅释义 | 释义+音标+记忆法+短语+同义词+同根词+真题 |
| 安装方式 | App Store | App Store | Chrome 商店 | 浏览器直接打开 |
十四、为什么做这个方向
14.1 市场需求刚性
中国每年 2500-3000 万英语考试备考群体(四六级、考研、雅思、托福),词汇学习是刚需。
14.2 技术成熟
Web 技术已足够强大:
- PWA 实现类原生体验
- IndexedDB 支持大量离线数据
- Canvas 实现精确字幕渲染
- WebAssembly 运行 Whisper 模型
- Supabase 提供开箱即用的后端服务
无需原生 App,一个 Web 应用即可覆盖全平台。
14.3 差异化明显
市场空白——没有产品把「视频场景」作为记忆锚点,串联查词和复习。词映 VocScreen 是唯一做到「看剧 → 查词 → 学习 → 复习 → 视频回看」完整闭环的产品。
14.4 个人优势
我自己就是用户,对痛点有深刻理解。作为独立开发者,可以快速迭代,不受产品经理和开发周期约束。
十五、开发规范
15.1 架构约束
- 引擎层:纯逻辑,无 UI 依赖。每个引擎独立类:SubtitleRenderer、SrtParser、TranslateEngine、Lemmatizer、MatcherEngine、AsrEngine、ClipCapture、DictEngine
- 组件层:模块化组件,分为 player、vocabulary、toolbar、statistics、UI primitives
- 状态层:Zustand stores,按职责拆分(Player / UI / Vocab / Review / Subtitle / Auth)
- 数据层:IndexedDB via Dexie.js,Supabase sync for cross-device
15.2 代码规范
- TypeScript 严格模式,全量类型覆盖
- 函数组件 + Hooks,无 class 组件
verbatimModuleSyntax:type import 必须用import type- 命名:PascalCase(组件/类型)、camelCase(变量/函数)、UPPER_SNAKE(常量)
15.3 核心约束(Hard Constraints)
- Canvas 元素不可设置全局
pointer-events: none(否则无法点击单词) - 视频文件存储在腾讯 COS,访问权限为「公有读私有写」
- 视频加载必须使用 Range 请求(需 CORS 配置 Content-Range 头)
- 用户认证使用邮箱验证
- 数据隔离使用 Supabase RLS
- 词汇学习使用交错学习流程(不同单词交替通过阶段)
- 释义选项必须为纯中文,不含英文术语或词性标签
- 学习完成后单词立即加入复习队列
- 视频片段回看功能(「原声」按钮)永远不可删除
- 单词详情页必须显示全部词书内容
videoSentence(视频原句)和exampleSentence(词书例句)是独立字段,不可合并
15.4 教训总结
- koa-connect wrapper 导致 ctx 泄漏,优先使用原生实现
- 大视频文件(300MB+)使用 COS + Range 请求,不打包进项目
- 渲染阶段调用 setState 违反 React 规则,导致不稳定
- 未撤销的 ObjectURL 导致视频组件内存泄漏
- 对非 string 类型字段直接调用
.match()导致运行时崩溃 - 单单词阶段完成流程导致学习留存差,需交错学习
- 词书数据质量很重要(CET6 原词书有
anybody → 重要人物的错误数据) parseSenses不可将tranOther(英文释义)映射到例句字段combinedDict的「先到先得」策略意味着错误的首条数据会阻止正确数据,加载顺序很重要
十六、部署方案
16.1 部署架构
用户浏览器
    │
    ├── HTTPS ──► Vercel CDN ──► 前端静态资源 (JS/CSS/HTML)
    │
    ├── HTTPS ──► 腾讯 COS ──► 视频文件 (Range 请求)
    │
    └── HTTPS ──► Supabase ──► 认证 + 数据库 (RLS)
16.2 环境变量
| 变量名 | 值 | 说明 |
|---|---|---|
VITE_SUPABASE_URL | https://vkgysxgqtjxmepglefpc.supabase.co | Supabase 项目 URL |
VITE_SUPABASE_ANON_KEY | sb_publishable_xxx | Supabase 匿名密钥 |
16.3 部署步骤
- Supabase:执行
supabase-schema.sql,开启邮箱验证,配置重定向 URL - GitHub:推送代码到 GitHub 仓库
- Vercel:导入 GitHub 仓库,配置环境变量,自动部署
- 腾讯 COS:配置 CORS(允许 Vercel 域名),设置
Content-Disposition: inline
16.4 Vercel 配置
// vercel.json
{
  "headers": [
    {
      "source": "/mock/(.*).json",
      "headers": [
        { "key": "Cache-Control", "value": "no-cache, no-store, must-revalidate" }
      ]
    }
  ]
}
十七、版本历史
v2.0.0(2026-07)
重构升级:
- 从 v1 完全重构,修复多个核心 bug(hitMap 分隔符、单词匹配、Space 键状态过期)
- 新增三阶段认知链 + 交错学习
- 新增视频片段回看功能(核心差异化)
- 词书从 CET4/CET6/IELTS/TOEFL 替换为新东方 JSONL 数据(更高准确性、更丰富内容)
- 新增 Supabase 邮箱认证 + 云同步
- 新增 PWA 支持(离线可用、可安装)
- 新增单词详情页(展示全部词书内容)
- 新增艾宾浩斯复习系统
- 部署到 Vercel + Supabase + 腾讯 COS
v1.0.0(2026-06)
- 基础视频播放 + Canvas 字幕渲染
- 单词点击查词
- 基础生词本
- 存在多个 bug(已由 v2 修复)
十八、已知问题与注意事项
18.1 技术注意事项
- React Strict Mode:开发模式下组件双挂载,视频
onError不可调用video.load(),否则会中止第二次成功加载 - IndexedDB 清空:不可在 React 运行时逐表清空(触发 Dexie 通知 → React 重渲染 → 渲染循环),需用「标记 → 刷新 → 启动时删除」模式
- CORS 配置:腾讯 COS 需暴露
Content-Range、Content-Length、ETag头,否则 Range 请求失败 - Service Worker 缓存:大型 JSON 文件(词书 5-6MB)不预缓存,改为运行时
StaleWhileRevalidate;演示字幕直接 import 到 JS bundle - Supabase 免费版:项目 7 天无活动会自动暂停,部署后有用户访问即不会暂停
18.2 字段分离约束
videoSentence(视频字幕原句)和exampleSentence(词书例句)是独立字段- 「原声」按钮始终对应
videoSentence,确保文本与音频一致 videoClipStart/videoClipEnd独立保存,即使使用词书例句也不丢失- VideoClipModal 接收
videoSentence(非exampleSentence)
18.3 数据质量
- 词书已从原始 CET4/CET6/IELTS/TOEFL 替换为新东方 JSONL 数据
parseSenses不可将tranOther(英文释义)映射到例句字段combinedDict的「先到先得」策略意味着加载顺序很重要
词映 VocScreen — 看剧学英语,不知不觉的那种